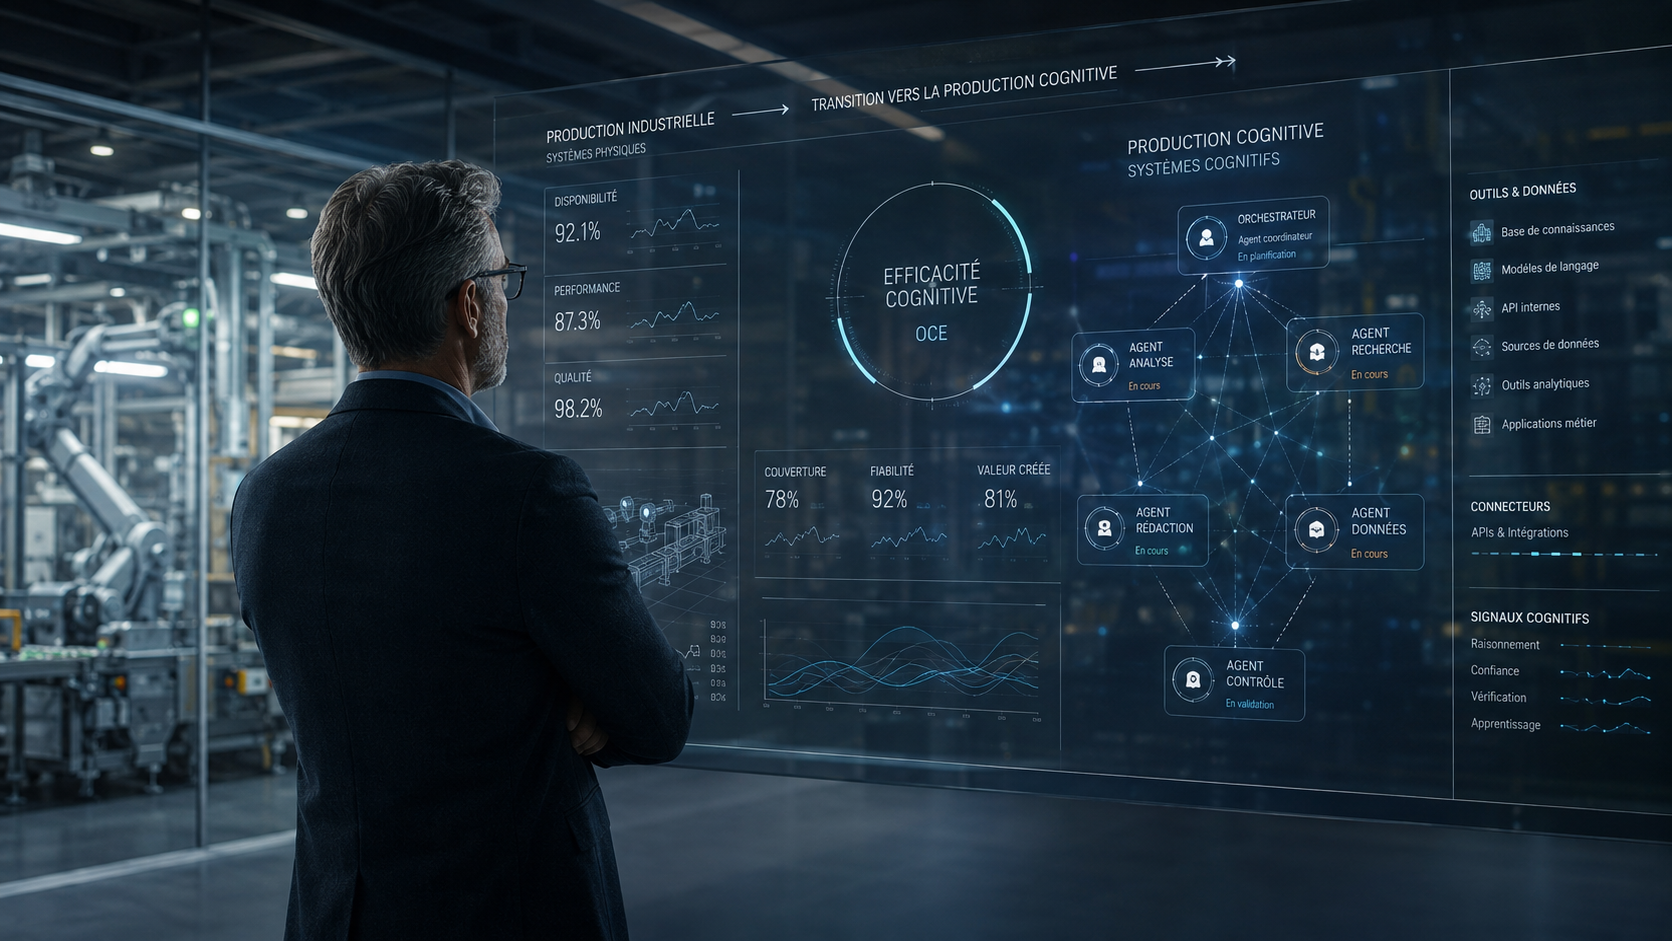
Les agents IA ne sont pas des logiciels que l’on installe. Ce sont de nouvelles unités de production dont il faut apprendre à mesurer le rendement.
Introduction
Lorsque j’ai étudié en génie industriel, une idée revenait constamment : on ne peut améliorer que ce que l’on est capable de mesurer. Cette idée est simple, mais elle est au cœur de presque toutes les disciplines qui cherchent à améliorer la performance d’un système. Que l’on parle de Lean Manufacturing, du Toyota Production System ou d’amélioration continue, la première étape consiste toujours à comprendre comment une organisation transforme ses ressources en valeur et, surtout, où cette transformation perd en efficacité.
À l’époque, j’associais naturellement cette réflexion au monde manufacturier : des systèmes composés d’opérateurs, de convoyeurs, de robots, de presses ou de centres d’usinage. Ce monde des machines a toujours été lié à une transformation du travail humain : l’artisan au tour manuel est devenu opérateur avec l’arrivée des commandes numériques, puis cet opérateur a fini par superviser plusieurs machines à la fois, en suivant les indications qu’on lui fournit.
Aujourd’hui, en observant les organisations déployer des agents autonomes capables de raisonner, de prendre des décisions, d’utiliser des outils et d’exécuter des tâches complexes, je retrouve exactement le même déplacement, appliqué au travail administratif : l’IA transforme l’employé qui exécutait en un opérateur qui supervise. La technologie a changé ; le problème de gestion, lui, demeure étonnamment similaire.
Et ce problème de gestion, ce n’est pas la technologie elle-même — c’est le fait de savoir si ce qu’elle produit est réellement efficace. Un opérateur qui supervise plusieurs machines a besoin de savoir laquelle tourne au ralenti, laquelle s’est arrêtée sans le signaler, laquelle produit des pièces à rejeter. C’est exactement le même besoin qui se pose aujourd’hui face à des agents IA : comment savoir si un agent avance vraiment, s’il tourne en rond, ou s’il produit un résultat qu’il faudra corriger en aval.
Le manufacturier a résolu ce problème avec le TRG, ou taux de rendement global. C’est ce cadre, aujourd’hui avec l’automatisation agentique, que je propose maintenant de revisiter.
Le véritable apport du TRG
Le concept trouve son origine chez Toyota à la fin des années 1960. Seiichi Nakajima, alors qu’il développe la Total Productive Maintenance (TPM) pour le Japan Institute of Plant Maintenance, cherche un moyen de répondre à une question simple mais jusque-là mal mesurée : une machine disponible produit-elle réellement à son plein potentiel ? De ce travail naît l’Overall Equipment Effectiveness (OEE), que l’on connaît en français sous le nom de Taux de Rendement Global (TRG).
Le TRG est souvent résumé à une formule combinant la disponibilité, la performance et la qualité d’un équipement :
Chacun de ces trois ratios répond à une question précise, et c’est leur produit qui révèle où le potentiel théorique d’un actif se situe réellement :
-
Disponibilité — la machine a-t-elle tourné pendant le temps où elle aurait dû tourner ?
-
Performance — pendant qu’elle tournait, a-t-elle produit à la cadence attendue ?
-
Qualité — parmi ce qui a été produit, combien est réellement conforme ?
Un TRG de 100 % correspondrait à une machine ne produisant que des pièces conformes, à la cadence maximale, sans aucun arrêt. Dans la pratique, ce seuil n’est pour ainsi dire jamais atteint, et c’est précisément cet écart entre le potentiel théorique et le rendement observé que le TRG rend visible.
Sa contribution dépasse toutefois la seule mesure. En introduisant la notion de capacité théorique de production, le TRG a modifié la manière même dont on évalue une machine : il ne s’agit plus seulement de constater qu’elle fonctionne, mais de quantifier la part de son potentiel qui échappe encore à la production réelle.
Ainsi compris, le TRG ne mesure pas un équipement en tant que tel, mais la capacité d’un système à transformer le potentiel d’un actif de production en valeur réelle.
Une nouvelle catégorie d’actifs
Les organisations commencent à exploiter une nouvelle catégorie d’actifs opérationnels : hier des presses, des robots industriels et des centres d’usinage ; aujourd’hui des modèles de langage, des agents spécialisés et des infrastructures capables de produire de la capacité cognitive à grande échelle.
Et si on voyait un agent tel une machine au sens industriel du terme. C’est en ce sens qu’on peut le considérer comme une machine numérique — un actif de production.
Ces actifs ont un coût, consomment des ressources, et peuvent être ralentis, bloqués, mal configurés, sous-utilisés ou produire des résultats de qualité variable.
En d’autres termes, ils présentent eux aussi des pertes opérationnelles. Pourtant, contrairement aux équipements industriels, nous disposons encore de très peu d’outils pour mesurer avec rigueur la part de leur potentiel réellement transformée en valeur. En effet, des frameworks d’évaluation d’agents existent bel et bien : τ-bench et AgentBench testent leur capacité à accomplir des tâches réalistes, Braintrust, Confident AI suit leur taux de réussite, leur latence et leur coût.
Mais ces outils évaluent une tâche ou un modèle, pas un actif de production. Aucun ne demande, à l’échelle d’une chaîne d’agents : quelle part du potentiel théorique de cette capacité cognitive se transforme réellement en valeur, et où se dissout le reste ? Alors une question se pose : comment mesurer cette production de valeur réelle basé sur les capacités disponibles ?
Il serait tentant d’appliquer directement le TRG aux agents. Ce n’est pas la bonne approche car une unité cognitive raisonne, collabore, utilise des outils et évolue dans un environnement bien plus dynamique qu’un équipement industriel.
Le raisonnement qui a produit le TRG, en revanche, reste pertinent. Comme toute unité de production, une unité cognitive possède une capacité théorique, subit des pertes, et son efficacité devrait pouvoir être observée, mesurée et améliorée. C’est cette logique qui conduit à proposer un nouveau cadre : le Taux de Rendement Cognitif (TRC).
Repenser les trois piliers du TRG
Le TRG repose sur trois dimensions : la disponibilité, la performance et la qualité. Voici comment je propose de les repenser pour le monde agentique.
La disponibilité cognitive ne se limite plus à la question de savoir si un serveur répond. Un agent peut être techniquement disponible tout en étant fonctionnellement à l’arrêt : en attente d’une autorisation humaine, bloqué par un outil qui échoue silencieusement, coincé dans une boucle de clarification, ou simplement privé du contexte nécessaire pour agir. La disponibilité d’une unité cognitive se mesure à sa capacité à progresser vers un objectif, pas seulement à répondre à un ping.
La performance cognitive se mesure au débit réel de tokens produits par rapport au débit visé. Un agent qui emprunte un chemin de raisonnement inutilement long, qui rappelle un outil trois fois par excès de prudence, ou qui régénère un contexte déjà disponible, consomme du temps de traitement sans que ce temps se traduise en tokens de sortie utiles — ce qui réduit le débit perçu, même si le modèle lui-même n’a pas ralenti.
La qualité cognitive est peut-être la dimension la plus délicate, parce qu’une machine produit une pièce conforme ou non conforme, alors qu’un agent produit un résultat qui peut être partiellement correct, correct mais mal justifié, ou correct sans être exploitable en aval. Une sortie qui déclenche une intervention humaine de correction n’est pas différente, du point de vue du système, d’une pièce rejetée en fin de ligne. Elle a consommé de la capacité sans produire de valeur nette.
Sur la base de ces trois dimensions, je propose le Taux de Rendement Cognitif (TRC), ou Overall Cognitive Effectiveness (OCE) : .
Le TRC a comme vocation de produire un vocabulaire commun pour repérer où le potentiel théorique se dissout en gaspillage.
Une première proposition de TRC
De la même manière que le TRG combine trois ratios mesurables, je propose de définir chaque dimension du TRC par un ratio équivalent, adapté au fonctionnement d’une unité cognitive autonome.
-
Disponibilité cognitive — l’agent a-t-il progressé vers l’objectif pendant le temps où il aurait dû le faire ?
Le temps « en progression effective » exclut l’attente d’une validation humaine, les blocages sur un outil en échec silencieux, ainsi que les boucles de clarification sans avancement. Vu plus globalement, un agent pouvant tourner 24 heures sur 24, ce ratio met en lumière un faible taux de disponibilité chez un agent qui ne roule que quelques heures par jour.
-
Performance cognitive — l’agent a-t-il produit à la cadence attendue ?
en sachant la période de temps analysé on pourrait aussi calculé cette performance par :
Un rappel d’outil redondant, un chemin de raisonnement inutilement long ou une régénération de contexte déjà disponible consomment du temps de traitement sans produire de tokens de sortie, ce qui fait chuter ce ratio même si le modèle sous-jacent n’a pas ralenti.
-
Qualité cognitive — quelle part des tokens produits a réellement contribué au résultat, plutôt que d’avoir servi à corriger ce qui aurait dû être bon du premier coup ?
Cela suppose de pouvoir distinguer, dans une session, les segments où l’agent est en statut « correctif » — reprise après un échec d’outil, régénération suite à un résultat rejeté, correction déclenchée par une intervention humaine — des segments où il produit normalement. Un token dépensé en correction n’a pas produit de valeur nette, au même titre qu’une pièce reprise en fin de ligne.
Le TRC se calcule alors comme le produit des trois :
L’intérêt du TRC est de rendre visibles des pertes aujourd’hui noyées dans la facture d’API, d’avoir une base de comparaison entre différent modèles pour une même tâche ou simplement de mieux gérer l’outillage industriel. Cette formulation reste une hypothèse de travail : contrairement au TRG, le TRC suppose une instrumentation encore à construire, notamment la capacité à distinguer les segments de session correctifs des segments productifs.
C’est ce diagnostic que le manufacturier fait avec rigueur depuis des décennies, et que les organisations qui déploient des agents n’ont, pour l’instant, presque aucun moyen de faire.
La suite
Le TRC n’est pas un cadre complet, mais une hypothèse de travail. Sa formule exacte importe moins que le changement de posture qu’elle propose.
Une limite subsiste : une machine CNC ne réfléchit pas avant de produire, un agent, si. Ce temps de raisonnement s’apparente à un réglage de machine — une étape légitime qui devrait compter dans la disponibilité, pas dans les pertes. Mais où s’arrête le réglage et où commence le gaspillage ? Le TRC, tel que défini ici, ne tranche pas encore entre réflexion productive et réflexion excessive.
La performance des systèmes d’IA est évaluée par le modèle seul : précision, vitesse, coût par token. Ce sont des mesures utiles, mais elles décrivent le modèle et non la machine pour laquelle nous l’utilisons.
Les organisations qui déploient des agents IA devront définir cette nouvelle performance machine : cesser de se demander si le modèle est bon, et se demander si le système (la machine) qui l’entoure transforme réellement son potentiel en valeur.